Índice de contenido
- Por qué una mala estructura te pasa factura
- Qué significa Clean Code aplicado a FastAPI
- Clean Code no es escribir más capas
- Principios que realmente importan en una API
- Clean Architecture como consecuencia natural
- Separación de responsabilidades en FastAPI
- Capas y dependencias: hacia dónde debe apuntar el código
- Herramientas: Google Antigravity (Gemini)
- Preparación y conceptos de arquitectura
- ¿Qué es Clean Architecture y Clean Code?
- Clean Code vs. Clean Architecture
- El Prompt y la Refactorización
- Ejecución del Plan
- El Problema de los WebSockets
- Resultado: La nueva estructura
- Interface Adapters
- Use Cases (Casos de Uso)
- Entities (Entidades)
- Frameworks & Drivers
- Dependencias y patrón Repository en FastAPI
- ¿Qué es el Patrón Repository?
- ¿Por qué es útil?
- Más allá de cambiar la base de datos
- Estructura básica del patrón Repository
- 2. La implementación (el adaptador)
- 3. La capa de acceso mediante dependencias
- 4. Consumo desde el endpoint
- Ejemplo práctico de cambio de base de datos
- Caso real: mi propia plataforma
- Relación con la arquitectura hexagonal que implementamos antes
- Ventajas Reales del Patrón Repository
- Beneficios reales de aplicar Clean Code en FastAPI
- Código más fácil de mantener y testear
- Escalar sin miedo a romperlo todo
- Errores comunes al aplicar Clean Architecture en FastAPI
- Copiar arquitecturas sin entenderlas
- Convertir Clean Code en burocracia
- Conclusión: Clean Code para no volver a empezar de cero
- Preguntas frecuentes sobre Clean Code en FastAPI
Vamos a realizar un pequeño experimento. Tomaremos nuestro proyecto actual —el cual no sigue precisamente las mejores prácticas organizativas, ya que nació como una prueba rápida para implementar WebSockets— y vamos a mejorar su estructura siguiendo los principios que ya exploramos en El ciclo de vida de una app en FastAPI con los eventos Lifespan.
Para ello, utilizaremos arquitecturas de software bien establecidas. No pretendo que esto sea un curso profundo sobre arquitecturas avanzadas, sino más bien una presentación práctica para despertar tu curiosidad. Más adelante podremos dedicarle una sección completa o un curso específico, pero si lo prefieres, también puedes investigar por tu cuenta. El momento es ideal: la aplicación es pequeña y manejable, lo que la convierte en el candidato perfecto para este tipo de refactorización.
Los proyectos empiezan pequeños, como casi todos. Un par de endpoints, algo de lógica en las rutas, una conexión a base de datos… todo parecía razonable. Pero a medida que el código crecía, mantener una buena estructura dejó de ser opcional. Fue ahí cuando descubrí Clean Code aplicado a FastAPI y entendí algo clave: ¿para qué reinventar la rueda si el problema ya está resuelto?
En este artículo te explico cómo aplicar Clean Code en FastAPI de forma práctica, sin dogmas ni sobre-ingeniería, para que tu API pueda crecer sin convertirse en un caos.
Por qué una mala estructura te pasa factura
FastAPI no te obliga a estructurar nada. Y eso es una ventaja… hasta que deja de serlo.
Los síntomas típicos de un proyecto sin arquitectura clara son fáciles de reconocer:
routersgigantes con decenas de endpoints mezclados- lógica de negocio duplicada en varios endpoints
- tests imposibles de escribir porque todo está acoplado
- miedo a tocar código "porque seguro rompe algo"
En mi caso, el crecimiento del proyecto fue el detonante. No estaba escribiendo mal código, pero sí estaba escribiendo código que no estaba preparado para crecer.
Qué significa Clean Code aplicado a FastAPI
Clean Code no es escribir más capas
Un error común es pensar que Clean Code significa:
"Más carpetas, más clases y más abstracciones".
No.
Clean Code en FastAPI significa:
- responsabilidades claras — cada módulo hace una sola cosa
- dependencias bien dirigidas — el flujo de dependencias apunta hacia el dominio, nunca hacia afuera
- código fácil de leer, testear y modificar — sin necesidad de recorrer cinco archivos para entender qué hace una función
No se trata de seguir una arquitectura por moda, sino de resolver problemas reales de mantenimiento.
Principios que realmente importan en una API
Al aplicar Clean Code en FastAPI, estos son los principios que marcan la diferencia:
- Separación de responsabilidades
HTTP no es lógica de negocio. Un endpoint que valida, consulta la base de datos y formatea la respuesta está haciendo demasiado. - Dependencias hacia adentro
La lógica de negocio no depende de frameworks. Si tuuse caseimporta directamente defastapi, algo está mal. - Código explícito
Que se entienda qué hace un módulo sin necesidad de leer cinco archivos. - Facilidad para testear
Sin levantar FastAPI ni una base de datos real. Si no puedes hacer un test unitario de tu lógica de negocio, es señal de que está demasiado acoplada al framework.
Cuando entendí esto, Clean Architecture dejó de parecer algo "académico" y pasó a ser una consecuencia natural del buen diseño.
Clean Architecture como consecuencia natural
Separación de responsabilidades en FastAPI
Una API bien estructurada se divide en capas conceptuales con responsabilidades bien definidas:
- API / Presentation → FastAPI, rutas,
request/response. Es la capa más externa y la única que "conoce" el protocolo HTTP. - Application → casos de uso. Orquesta la lógica sin importarle cómo llegó la petición.
- Domain → reglas de negocio puras, sin dependencias externas.
- Infrastructure → base de datos, servicios externos, ORM. Todo lo que puede cambiar.
La clave: FastAPI vive en la capa más externa. Ni los casos de uso ni las entidades saben que FastAPI existe.
Capas y dependencias: hacia dónde debe apuntar el código
La regla de oro:
Las capas internas no saben que FastAPI existe.
Esto te permite:
- cambiar FastAPI por otro framework sin tocar la lógica de negocio,
- cambiar la base de datos sin romper los casos de uso,
- testear la lógica directamente, sin HTTP ni infraestructura real.
Y aquí es donde muchos proyectos se rompen: si no hay una estructura clara desde el principio, cada cambio se convierte en una operación de alto riesgo.
Herramientas: Google Antigravity (Gemini)
Para este trabajo utilizaré Google Antigravity, el editor que ves en pantalla. Si no lo conoces, es un entorno de desarrollo basado en VS Code que integra agentes de IA de Gemini directamente en tu espacio de trabajo, similar en concepto a Windsurf o Cursor, pero con una propuesta diferenciada.
Una de sus funciones más interesantes es el modo Planning (Planificación). A diferencia de otras extensiones para VS Code, esta herramienta genera una "hoja de ruta" antes de aplicar cualquier cambio al código. Esto es extremadamente útil porque te permite revisar y ajustar el plan antes de que el agente modifique tus archivos, evitando sorpresas y reduciendo errores en refactorizaciones grandes.
Preparación y conceptos de arquitectura
Antes de pedirle cambios globales a la IA, es fundamental sincronizar tu proyecto con GitHub. Las cosas pueden salir mal —especialmente en una refactorización de esta escala— y tener un respaldo te ahorrará mucho tiempo si necesitas revertir los cambios.
¿Qué es Clean Architecture y Clean Code?
Seguramente has oído hablar de Clean Architecture y Clean Code. Vamos a ver qué es cada uno y, sobre todo, en qué se diferencian.
Clean Code vs. Clean Architecture
Es importante aclarar algo antes de continuar:
- Clean Code no es una arquitectura, es una filosofía. Se enfoca en escribir código simple, modular, legible y mantenible.
- Clean Architecture es la aplicación práctica y estructural de esos principios.
Es como la diferencia entre API y REST API: uno es el concepto general y el otro es su implementación concreta.
En esencia, Clean Code son formas de organizar el código basadas en buenos principios. Ya hemos aplicado algo de esto al separar esquemas y modelos, pero de forma incompleta. La ventaja de adoptar una arquitectura existente es no reinventar la rueda: en lugar de inventar nombres para nuestras carpetas, usamos estructuras probadas que hacen que el código sea legible, mantenible y escalable.
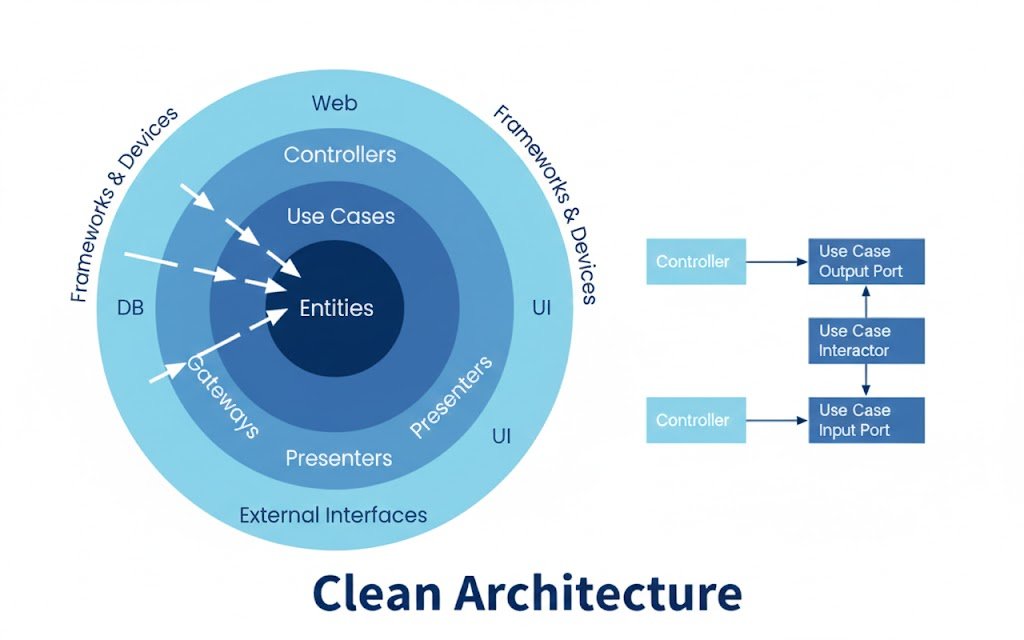
La estructura que buscamos generar se divide en las siguientes capas:
- Entities (Entidades): La lógica de negocio más pura, sin dependencias de ningún framework.
- Use Cases (Casos de Uso): Acciones específicas del negocio (crear un usuario, hacer login). Es el corazón de la lógica de la aplicación. Aquí se define qué sucede cuando un usuario hace login, independientemente de si la petición llega por
REST API,WebSocketo cualquier otro protocolo.- En el ejemplo del login, el caso de uso se encarga de:
- Verificar que el usuario existe.
- Validar la contraseña.
- Generar y devolver el token.
- Antes, esta lógica estaba dentro del endpoint. Ahora está desacoplada, lo que permite que no dependa del tipo de respuesta ni de FastAPI, y pueda reutilizarse desde cualquier capa de presentación.
- En el ejemplo del login, el caso de uso se encarga de:
- Interface Adapters: Controladores y repositorios que actúan como traductores entre el mundo exterior y los casos de uso. Aquí residen los controladores que reciben peticiones
HTTP,WebSocket,JSONoXML, y los repositorios que abstraen el acceso a datos. - Frameworks & Drivers: Herramientas externas como la base de datos o el framework web (
FastAPI). Aquí reside el código que "no es nuestro": la configuración de FastAPI, la conexión a la base de datos conSQLAlchemy, o cualquier ORM. Si mañana queremos cambiar FastAPI por Flask o Django, solo deberíamos tocar esta capa.
El Prompt y la Refactorización
Para que el agente de IA sea efectivo, necesitamos un buen prompt. El resultado fue el siguiente:
"Actúa como un experto en arquitectura de software. Refactoriza mi aplicación FastAPI siguiendo los principios de Clean Code. Separa el código en capas de
Entities,Use Cases,InterfacesyAdapters. Implementa el patrón Repository para el acceso a datos, asegurando que las dependencias apunten hacia adentro. Genera la nueva estructura de carpetas y los archivos correspondientes."
Ejecución del Plan
Al activar el modo Planning, el agente muestra exactamente qué archivos creará y qué carpetas moverá. En este caso, crea una carpeta src/ con subcarpetas para entidades, casos de uso (como login_use_case.py) y repositorios. Revisar este plan antes de ejecutarlo evita sorpresas y permite ajustar el alcance de la refactorización.
El Problema de los WebSockets
Durante la refactorización, hubo un pequeño error con los WebSockets debido a la confusión entre versiones del proyecto. El agente generó inicialmente un socket muy simple que solo devolvía texto plano. Tuve que pedirle una corrección específica:
"Adapta el endpoint de WebSockets llamado
websocket_endpointa la arquitectura limpia, integrando elConnectionManagerque teníamos anteriormente."
Esto es completamente normal al trabajar con agentes de IA en refactorizaciones grandes: el primer intento raramente es perfecto, y parte del proceso es guiar al agente con correcciones puntuales y contexto adicional.
Resultado: La nueva estructura
Veamos los archivos más importantes para entender cómo quedó organizada la arquitectura.
El punto de entrada de la aplicación quedó en su mínima expresión, delegando toda la lógica a los controladores:
main.py
"""Application entry point."""
from src.frameworks_drivers.http.app import app
src/frameworks_drivers/http/app.py
from src.interface_adapters.controllers import (
    auth_controller,
    alerts_controller,
    rooms_controller,
    websocket_controller
)
***
# Include routers with /api prefix
app.include_router(auth_controller.router, prefix="/api")
app.include_router(alerts_controller.router, prefix="/api")
app.include_router(rooms_controller.router, prefix="/api")
Interface Adapters
Aquí se encuentran los controladores: la puerta de entrada de nuestra app. Aunque es cierto que resulta prácticamente imposible cumplir al 100% con los principios del Clean Code (en esta capa idealmente no debería haber código de FastAPI), en la práctica los controladores de FastAPI actúan como la capa intermedia que conecta la presentación con los casos de uso, siguiendo un esquema similar al MVC:
src/interface_adapters/controllers/alerts_controller.py
@router.get("/alerts", response_model=List[Alert])
def get_alerts(
    room_id: Optional[int] = None,
    user: User = Depends(get_current_user),
    alert_repo=Depends(get_alert_repository)
):
    """Get alerts endpoint with optional room filtering."""
    use_case = GetAlertsUseCase(alert_repo)
    alerts = use_case.execute(room_id=room_id)

    # Convert entities to ORM-compatible format for Pydantic
    return [
        {
            "id": alert.id,
            "content": alert.content,
            "created_at": alert.created_at,
            "user_id": alert.user_id
        }
        for alert in alerts
    ]
En este controlador, la base de datos se inyecta como una dependencia a través de Depends(), ya que puede ser cualquier cosa: MariaDB, PostgreSQL, un JSON, Firebase, un archivo plano… Siguiendo los principios del Clean Code, esto se maneja así para que sea débilmente acoplada, lo que significa que podemos cambiar la fuente de datos sin romper los controladores ni otras capas.
Además, los controladores delegan la lógica de negocio directamente a los casos de uso.
Use Cases (Casos de Uso)
src/use_cases/auth/login.py
"""Login Use Case - Handles user authentication."""
from typing import Optional
import bcrypt
from src.entities.user import User
from src.entities.token import Token
from src.interface_adapters.repositories.repository_interfaces import (
    UserRepositoryInterface,
    TokenRepositoryInterface
)


class LoginUseCase:
    """Use case for user login."""

    def __init__(
        self,
        user_repository: UserRepositoryInterface,
        token_repository: TokenRepositoryInterface
    ):
        self.user_repository = user_repository
        self.token_repository = token_repository

    def execute(self, username: str, password: str) -> Optional[str]:
        """
        Execute login use case.

        Args:
            username: User's username
            password: User's plain password

        Returns:
            Token key if successful, None otherwise
        """
        # Get user by username
        user = self.user_repository.get_by_username(username)
        if not user:
            return None

        # Verify password
        if not self._verify_password(password, user.password):
            return None

        # Get or create token
        token = self.token_repository.get_by_user_id(user.id)
        if not token:
            import secrets
            token = Token(
                key=secrets.token_hex(20),
                user_id=user.id
            )
            token = self.token_repository.create(token)

        return token.key

    @staticmethod
    def _verify_password(plain_password: str, hashed_password: str) -> bool:
        """Verify password against hash."""
        password_byte_enc = plain_password.encode('utf-8')
        hashed_password_enc = hashed_password.encode('utf-8')
        return bcrypt.checkpw(password_byte_enc, hashed_password_enc)
En este módulo reside la lógica de negocio. No le importa de dónde vienen los datos ni cuál es el formato de respuesta esperado. Esta capa trabaja con una entidad genérica —ni los modelos de Pydantic ni el ORM—, porque al ser lógica de negocio pura, debe mantenerse completamente desacoplada del framework.
Para comparar, así era antes en el enfoque tradicional:
rest_api.py
@router.post("/login")
def login(request: schemas.LoginRequest, db: Session = Depends(get_db)):
    user = db.query(models.User).filter(models.User.username == request.username).first()

    if not user:
        return JSONResponse("User invalid", status_code=status.HTTP_401_UNAUTHORIZED)

    if not verify_password(request.password, user.password):
        return JSONResponse("Password invalid", status_code=status.HTTP_401_UNAUTHORIZED)

    # Get or Create Token
    token = db.query(models.Token).filter(models.Token.user_id == user.id).first()
    if not token:
        token = models.Token(user_id=user.id)
        db.add(token)
        db.commit()
        db.refresh(token)

    return {"token": f"Token_{token.key}"}
Toda la lógica de autenticación estaba mezclada con la gestión de la sesión de base de datos (db: Session) y el formato de respuesta HTTP. Con la nueva arquitectura, cada responsabilidad vive en su capa correspondiente: mayor abstracción, sin acoplamiento al framework y sin dependencia de un tipo de retorno concreto. Esto permite reutilizar el caso de uso tanto desde una API REST como desde un template con Jinja2, un CLI o cualquier otro punto de entrada.
Entities (Entidades)
En el proyecto tenemos tres tipos de entidades. Dos de ellas estaban fuertemente acopladas a la tecnología:
src/frameworks_drivers/db/orm_models.py — modelos del ORM con SQLAlchemy
src/interface_adapters/presenters/schemas.py — esquemas de Pydantic para FastAPI
Ambas están ligadas a código que no es propio: la base de datos a través de SQLAlchemy, y los esquemas de validación a través de Pydantic. Y luego tenemos las entidades puras del dominio, definidas como dataclass —equivalentes a los data classes de Kotlin—, cuyo único propósito es representar los datos del negocio sin ninguna dependencia externa:
src/entities/
"""Alert entity - Core business model."""
from dataclasses import dataclass
from datetime import datetime
from typing import Optional

@dataclass
class Alert:
    """Alert entity representing a message in a room."""
    id: Optional[int]
    content: str
    user_id: int
    room_id: int
    created_at: Optional[datetime] = None
Siguiendo los principios del Clean Code, las aplicaciones deben tener un acoplamiento débil. Esto significa que podemos cambiar de framework (de FastAPI a Django o Flask, que no utilizan modelos de Pydantic) sin que los casos de uso se vean alterados. Algo que no sería posible si usáramos directamente clases de Pydantic en el dominio.
Frameworks & Drivers
En esta carpeta encontramos la implementación más acoplada a tecnologías externas: FastAPI y la base de datos con SQLAlchemy. Todo lo que aquí reside puede cambiar en cualquier momento sin impactar las capas internas. Si mañana migramos a otro framework o a otro ORM, los cambios estarán localizados aquí.
Dependencias y patrón Repository en FastAPI
Además de la arquitectura en capas, uno de los factores que hace que FastAPI destaque frente a otros frameworks de Python es su rendimiento: dependiendo de la implementación, puede ser 5, 7 o incluso 10 veces más rápido que alternativas como Django o Flask. Pero ese rendimiento solo se aprovecha al máximo cuando la arquitectura está bien diseñada.
El Patrón Repository es la pieza clave que nos ayuda a entender por qué las dependencias son tan importantes en este contexto.
El proyecto de ejemplo incluye:
- Una API para gestionar habitaciones (
rooms). - Un recurso de alertas (
alerts), que básicamente son mensajes. - Modelos para almacenar los datos.
- Gestión del usuario autenticado.
- Una REST API con endpoints definidos.
- Un endpoint de WebSocket.
Es un ejercicio pequeño, pero muy representativo para mostrar cómo la IA puede implementar el Patrón Repository dentro de una arquitectura hexagonal y separar los módulos de forma correcta.
¿Qué es el Patrón Repository?
El Patrón Repository es un mecanismo de abstracción que permite independizar la lógica de negocio de cómo y dónde se almacenan los datos.
En un desarrollo tradicional, solemos estar "atados" a una base de datos específica mediante un ORM (como SQLAlchemy). Si bien frameworks como Django o Flask permiten cambiar de motor de base de datos (de MySQL a PostgreSQL, por ejemplo) con relativa facilidad, el Patrón Repository va un paso más allá: nos permite cambiar la fuente de datos completa sin tocar la lógica de negocio.
¿Por qué es útil?
Imagina que tu proyecto crece y, por requerimientos del cliente, ya no puedes usar una base de datos relacional. Ahora necesitas consumir una API externa (como Firebase o Supabase), un archivo JSON o incluso un Excel. Sin este patrón, tendrías que reescribir casi toda la aplicación. Con él, solo cambias la implementación concreta del repositorio.
Más allá de cambiar la base de datos
Con Repository no solo puedes cambiar el motor de base de datos. También puedes cambiar completamente la fuente de datos por cualquiera de estas opciones:
- Una API externa.
- Firebase.
- Supabase.
- Un archivo JSON.
- Un Excel.
- Cualquier otra fuente.
Y puedes hacerlo sin romper tu aplicación.
Si lo haces de forma tradicional, referenciando directamente los modelos del ORM en todas partes (al estilo MVC clásico sin capa de abstracción), cuando cambias la fuente de datos, todo explota. Con Repository, no.
Estructura básica del patrón Repository
1. La interfaz (el contrato)
En Python, definimos una interfaz usando clases abstractas (ABC). Su propósito es definir un "contrato": qué métodos deben existir (get, create, delete…), pero no cómo funcionan internamente.
Esta interfaz define las firmas que cualquier implementación debe respetar:
- Obtener todos.
- Obtener por ID.
- Eliminar.
- Buscar.
- etc.
No hay conexión a base de datos aquí. Solo definición de métodos.
from abc import ABC, abstractmethod
from typing import List, Optional
from .models import Task

class TaskRepository(ABC):
    @abstractmethod
    def get_all(self) -> List[Task]:
        pass

    @abstractmethod
    def get_by_id(self, id: int) -> Optional[Task]:
        pass
2. La implementación (el adaptador)
Luego tenemos la clase concreta que implementa esa interfaz. Es aquí donde conectamos con la realidad: podemos tener un SQLAlchemyRepository o un FirebaseRepository. Ambos deben cumplir con el contrato de la interfaz. Es como un pendrive: no importa qué archivos tenga dentro, el conector USB (la interfaz) siempre es el mismo.
Por ejemplo:
SQLAlchemyRepositoryFirebaseRepositoryMongoRepository
Esta clase sí contiene la lógica específica para acceder a los datos.
from sqlalchemy.orm import Session
from .domain import TaskRepository

class SQLAlchemyTaskRepository(TaskRepository):
    def __init__(self, db: Session):
        self.db = db  # Inyectamos la sesión de la DB aquí

    def get_all(self) -> List[Task]:
        return self.db.query(Task).all()

    def get_by_id(self, id: int) -> Optional[Task]:
        return self.db.query(Task).filter(Task.id == id).first()
3. La capa de acceso mediante dependencias
Aquí es donde entra FastAPI con su sistema de inyección de dependencias.
Creamos una función que devuelve una instancia del repositorio. Esa función es nuestra "puerta de acceso" y la registramos con Depends():
from typing import Annotated
from fastapi import Depends
from sqlalchemy.orm import Session
from .database import get_database_session # Tu función con yield
from .infrastructure import SQLAlchemyTaskRepository
from .domain import TaskRepository

# Función que construye el repositorio inyectando la sesión
def get_task_repository(db: Session = Depends(get_database_session)) -> TaskRepository:
    return SQLAlchemyTaskRepository(db)

# Creamos un tipo Annotated para que el endpoint sea legible
TaskRepo = Annotated[TaskRepository, Depends(get_task_repository)]
Luego usamos Depends() para inyectarlo en cada endpoint.
¿Por qué usar anotaciones con Annotated?
Si vamos a usar esa dependencia muchas veces (obtener por ID, obtener todas, eliminar, filtrar por usuario…), no queremos repetir la misma declaración de Depends() en cada endpoint.
La solución es crear un alias con Annotated: así, si mañana cambiamos la fuente de datos, solo modificamos ese alias en un único lugar y todos los endpoints que lo usen se actualizan automáticamente.
4. Consumo desde el endpoint
Finalmente llegamos al endpoint. Aquí ocurre algo importante: el endpoint no sabe si los datos vienen de SQLite, PostgreSQL, Firebase o un archivo JSON. Solo sabe que llama a un método del repositorio. Eso es desacoplamiento real:
@router.get("/tasks", response_model=List[TaskSchema])
def list_tasks(repo: TaskRepo):
    # Aquí 'repo' es una instancia de SQLAlchemyTaskRepository,
    # pero el endpoint solo sabe que es un 'TaskRepository'
    return repo.get_all()
Ejemplo práctico de cambio de base de datos
Supongamos que tu jefe dice:
"No quiero usar SQLAlchemy, eso es viejo. Ahora usamos MongoDB."
Si tienes el Patrón Repository implementado correctamente, solo cambias la implementación concreta: creas un MongoTaskRepository que implemente la misma interfaz, y actualizas la función de inyección de dependencias.
No tocas:
- La lógica de negocio.
- Los endpoints.
- Los casos de uso.
Eso es lo elegante de este patrón.
El sistema de inyección de dependencias de FastAPI, combinado con Depends() y las anotaciones de tipo, es lo que hace posible este nivel de desacoplamiento de forma limpia y pythónica.
Caso real: mi propia plataforma
En mi plataforma de academia me ha pasado algo similar. Inicialmente tenía una estructura para cursos. Luego añadí libros. Después, pagos genéricos (payment).
Más adelante me di cuenta de que la estructura no era ideal y quería reorganizarla. Si hubiera implementado desde el inicio un patrón más desacoplado, esos cambios habrían sido mucho más sencillos de realizar.
También quiero dividir la base de datos porque está creciendo bastante. Con una estructura basada en repositorios, ese tipo de migración sería mucho más manejable.
Relación con la arquitectura hexagonal que implementamos antes
En el ejemplo anterior con arquitectura hexagonal, la IA generó una estructura con interfaz, implementación, dependencias, casos de uso y endpoints. Sin embargo, la implementación no quedó perfecta. En algunos puntos, el agente rompió el desacoplamiento haciendo conexiones directas a la base de datos dentro de los controladores:
@router.get("/rooms", response_model=List[Room])
def get_rooms(
    room_repo=Depends(get_room_repository),
    db: Session = Depends(get_db)
):
    """Get all rooms endpoint."""
    # Use ORM directly for this endpoint to maintain relationship loading
    # This is a pragmatic choice to avoid complex entity->schema mapping
    return db.query(RoomORM).all()
Y fíjate cómo en otro endpoint sí se aplica correctamente:
@router.get("/alerts", response_model=List[Alert])
def get_alerts(
    room_id: Optional[int] = None,
    user: User = Depends(get_current_user),
    alert_repo=Depends(get_alert_repository)
):
    """Get alerts endpoint with optional room filtering."""
    use_case = GetAlertsUseCase(alert_repo)
    alerts = use_case.execute(room_id=room_id)

    # Convert entities to ORM-compatible format for Pydantic
    return [
        {
            "id": alert.id,
            "content": alert.content,
            "created_at": alert.created_at,
            "user_id": alert.user_id
        }
        for alert in alerts
    ]
El endpoint de /alerts usa correctamente el repositorio sin acceder a la base de datos directamente. El de /rooms, en cambio, inyecta tanto el repositorio como la sesión de base de datos (db: Session), lo que rompe el desacoplamiento: el controlador está tomando una responsabilidad que debería pertenecer al repositorio. Además, no emplea las anotaciones de tipo para simplificar el acceso al repositorio.
Esto demuestra algo importante:
- Los patrones no se siguen al pie de la letra desde el primer intento.
- Se adaptan según el contexto.
- Y se mejoran con el tiempo.
Ventajas Reales del Patrón Repository
Este enfoque no es solo teoría; tiene aplicaciones prácticas inmediatas que se notan a medida que el proyecto crece:
- Escalabilidad: Puedes tener un repositorio "Gratis" (más lento, en SQL local) y uno "Pro" (más rápido, usando Redis o un servicio externo) y alternarlos según el plan del usuario, sin tocar los endpoints.
- Migraciones sin dolor: Si decides migrar a MongoDB por necesidad o por rendimiento, solo creas un nuevo
MongoRepository, cambias la inyección de la dependencia y la lógica de tu aplicación permanece intacta. - Mantenimiento real: Como me pasó en mi propia plataforma de cursos, a veces necesitas cambiar cómo se gestionan los pagos o las notas de las clases. Si tienes repositorios separados, puedes evolucionar una parte del sistema sin romper el resto.
Beneficios reales de aplicar Clean Code en FastAPI
Código más fácil de mantener y testear
Una de las ventajas más inmediatas de esta arquitectura es la testeabilidad. Ahora puedes escribir tests unitarios de tu lógica de negocio sin levantar FastAPI ni una base de datos real, usando repositorios en memoria:
async def test_create_user():
   repo = InMemoryUserRepository()
   use_case = CreateUser(repo)
   user = await use_case.execute(data)
   assert user.email == "test@test.com"
Sin FastAPI. Sin base de datos. Solo lógica pura.
Escalar sin miedo a romperlo todo
Cuando el proyecto crece, una arquitectura limpia te permite:
- añadir nuevas features sin tocar rutas existentes
- cambiar la infraestructura sin afectar la lógica de negocio
- mantener el código legible para cualquier desarrollador que se incorpore al proyecto
Y ahí entiendes que Clean Code no es un lujo, es una inversión que se amortiza rápido.
Errores comunes al aplicar Clean Architecture en FastAPI
Copiar arquitecturas sin entenderlas
El mayor error es copiar estructuras enormes de repositorios de GitHub sin entender su propósito.
Clean Code no es "copiar carpetas", es entender responsabilidades y aplicarlas donde tienen sentido.
Convertir Clean Code en burocracia
Si cada cambio pequeño requiere crear 5 archivos nuevos, algo está mal.
La arquitectura debe ayudarte, no frenarte. Un buen indicador es este: si tu Clean Architecture complica más de lo que simplifica, es probable que estés sobre-ingeniando para el tamaño actual del proyecto.
Los principios que sí deben estar presentes desde el principio, independientemente del tamaño:
- cada archivo tiene una responsabilidad
- el negocio es independiente del framework
- FastAPI no controla tu arquitectura, tú sí
- puedes cambiar DB, framework o estructura sin reescribir todo
Conclusión: Clean Code para no volver a empezar de cero
Clean Code apareció en mi radar cuando el proyecto empezó a crecer y la estructura inicial ya no era suficiente. No fue una decisión teórica, fue práctica: llegó un punto en el que añadir una feature nueva se volvió arriesgado.
Fue ahí cuando entendí que no tenía sentido reinventar la rueda cuando ya existían principios diseñados exactamente para resolver ese problema.
FastAPI te permite avanzar rápido.
Clean Code te permite seguir avanzando sin romperlo todo.
La combinación de ambos es lo que hace que una API pase de "funciona" a "es sostenible y escalable".
FastAPI es poderoso porque te invita a pensar en firmas de tipos y en dependencias explícitas. Esta estructura puede parecer compleja al principio, pero es precisamente lo que permite que el código sea testeable, mantenible y extremadamente eficiente. Al final del día, a tu endpoint no le interesa cómo obtienes los datos, solo le interesa devolverlos correctamente.
Preguntas frecuentes sobre Clean Code en FastAPI
- ¿Clean Architecture es demasiado para un proyecto FastAPI?
- No, si se aplica con criterio y de forma progresiva. Puedes empezar separando solo los casos de uso y escalar la arquitectura a medida que el proyecto lo requiera.
- ¿Cuándo debería empezar a aplicarla?
- Cuando el proyecto empieza a crecer o cuando sabes desde el principio que va a hacerlo. No esperes a que el caos sea el detonante.
- ¿Es obligatoria esta estructura exacta?
- No. Lo importante es el concepto, no la forma exacta. Adapta los principios a las necesidades de tu proyecto.
- ¿Vale la pena en proyectos pequeños?
- Tal vez no completa, pero sí los principios básicos: separación de responsabilidades y dependencias bien dirigidas siempre aportan valor.
Siguiente paso: FastAPI WebSockets: Guía Completa con Autenticación, REST API y Vue.js
Código fuente:
https://github.com/libredesarrollo/curso-libro-django-vue-channels
https://github.com/libredesarrollo/fastapi-websockets